¿Qué es un web scraper, cómo funciona y para qué se usa?
El web scraping o raspado web es una técnica para extraer datos públicos de Internet y transformar información no estructurada en datos útiles para análisis de mercado, monitorización de precios o entrenamiento de modelos de Inteligencia Artificial. Analizamos diversas técnicas de extracción de datos y veremos casos de uso que pueden ofrecerte nuevas ideas para desarrollar productos digitales o mejorar tus aplicaciones.
- ¿Qué es un web scraper?
- ¿Cómo funciona un web scraper?
- ¿Para qué se usa un web scraper?
- Herramientas sin código y extensiones de navegador para usar un web scraper gratis
- Web scraper Python vs. Web scraper JS
- La evolución del web scraper AI y los agentes autónomos
- Preguntas frecuentes sobre el web scraping
- ¿Es legal realizar extracción de datos web en sitios públicos?
¿Qué es un web scraper?
Web scraper es un tipo de aplicación web que se usa para obtener datos de sitios web y procesarlos, de modo que se extrae información útil que sirve para alimentar aplicaciones, servicios o procesos digitales.
Consiste en un tipo de aplicación que se conecta con sitios web mediante el protocolo HTTP, el mismo que utiliza el navegador, para obtener los datos que están publicados en páginas web. Una vez obtenida la información, puede extraer datos que interesan y almacenarlos en una base de datos, o realizar cualquier otro tipo de operación para cubrir objetivos de lo más diverso.
Y a todas las técnicas relacionadas con esta tarea se les denomina habitualmente web scraping o simplemente raspado web.
¿Cómo funciona un web scraper?
En los siguientes puntos vamos a explicar cómo funciona un web scraper, de modo que puedas entender la base de este tipo de aplicaciones de extracción de datos.
Envío de solicitudes HTTP y recepción del código fuente del servidor
Todo comienza con el envío de una solicitud. HTTP hacia un servidor web disponible en Internet. Esa solicitud HTTP es la misma que realiza el navegador cuando quiere acceder a una página ubicada en la web, cuando un usuario escribe una dirección en la barra de direcciones.
Cuando se recibe la respuesta el navegador web tiene el código HTML de la página web consultada y la usa para renderizar el contenido en la pantalla. Un web scraper utiliza exactamente el mismo procedimiento para obtener el código HTML de una página web, pero una vez recibe la información la usa para extraer datos.
Análisis del Document Object Model (DOM) y parseo del código HTML
La página web recibida se compone por código HTML en el cual están mezclados los datos que realmente desea obtener con etiquetas HTML y muchas otras informaciones que probablemente no resulten nada relevantes para el sistema.
Para conseguir que el web scraper obtenga los datos que realmente requiere tiene que realizar un análisis del código HTML, lo que incluye interpretar la estructura del marcado y recorrer el árbol de contenidos hasta encontrar aquella información que iba buscando.
El árbol de contenidos se encuentra definido por las etiquetas HTML en lo que conocemos como DOM, que son las siglas de Document Object Model. Existen numerosas librerías que consiguen interpretar el DOM para procesarlo y obtener la información que albergan las etiquetas HTML.
Localización de elementos clave mediante selectores CSS y rutas XPath
Interpretar el DOM no es un trabajo trivial, pero como todo existen numerosas librerías que nos facilitan la labor. Esas librerías utilizan tecnologías abiertas que forman parte de la propia web como los selectores CSS o las rutas XPath.
Por medio de esas herramientas conseguimos dirigirnos exactamente a los lugares del documento donde se encuentra la información que necesitamos obtener. Una vez localizados los elementos HTML específicos, podemos obtener el contenido objetivo de nuestras consultas.
Extracción, filtrado y limpieza de datos no estructurados
Para la extracción de los datos también se requieren varios pasos. Una vez localizados los elementos que contienen los datos se acceden a los contenidos textuales de las etiquetas, solo que esta información todavía tenemos que procesarla para obtener el juego de datos que necesitamos y con el formato que queremos conseguir.
Por ejemplo, podemos hacer un sistema de raspado para obtener los precios de la cesta de la compra en un supermercado. Probablemente nuestro sistema necesitará obtener nombres de productos descripciones y sus precios, aunque es posible que haya que procesar los datos, por ejemplo, para resumir las descripciones o quitar el símbolo del euro en los precios.
Todo eso se realiza de manera programática en el web scraper para obtener los datos tal como los necesitamos.
Almacenamiento organizado en formatos estructurados como JSON, CSV o SQL
Una vez obtenidos los datos, el siguiente paso consiste en almacenarlos. Aquí ya depende del tipo de tecnología que estemos utilizando y el objetivo del sistema de raspado.
Existen varias posibilidades como por ejemplo enviar los datos a una base de datos, para lo cual probablemente compondremos consultas SQL contra el motor de base de datos de nuestro servidor. A veces los datos viajarán por HTTP hacia otros servicios web, enviando documentos JSON. Incluso puede que necesites los datos en algún otro archivo que nos permita luego importarlo en otra aplicación, como por ejemplo una hoja de cálculo en Excel o formato CSV.
¿Para qué se usa un web scraper?
Un web scraper se puede utilizar para solventar necesidades diversas que dependen del tipo de negocio que requiera esos datos. Para concretar un poco más vamos a resumir en los próximos puntos algunos de los casos de uso más habituales.
Monitorización de precios y análisis de la competencia en comercio electrónico
Con un sistema de raspado podríamos monitorizar los precios de comercios electrónicos de la competencia, de modo que podamos analizar el mercado de manera automática y responder ante los movimientos de precios en sitios web similares al nuestro.
Esta es una práctica muy habitual y para ella a veces se integra sistemas basados en Inteligencia Artificial, que permiten aplicar cierta inteligencia durante el procesamiento de los datos y modificar automáticamente los precios en nuestro propio comercio electrónico. Esta es la base para conseguir, por ejemplo, unos precios dinámicos.
Prospección de ventas B2B y extracción de contactos comerciales
También se puede hacer un sistema de raspado para obtener datos de contacto de empresas, un paso muy útil para conseguir aumentar nuestros prospectos, la libreta de posibles interesados en nuestros productos y servicios.
Agregación de contenidos, noticias y publicaciones en tiempo real
Los sistemas de agregación de contenidos, que rastrean las noticias en diversos medios para poder mostrarlas en una única interfaz centralizada, utilizan sistemas de raspado para obtener las cabeceras de las noticias o las principales imágenes de los artículos.
Estudios de mercado, minería de datos y análisis de tendencias de consumo
También se puede utilizar sistemas de web scraping para obtener datos diversos con los cuales alimentar sistemas de análisis y mejorar la relevancia de las informaciones de los sistemas automáticos de análisis. A esto se le llama realizar minería de datos y es una excelente manera de mejorar los análisis de mercado y detectar tendencias de consumo.
Recopilación de grandes conjuntos de datos para el entrenamiento de modelos de IA
Para el entrenamiento de modelos de IA requerimos una cantidad enorme de información. En la web existe toda esa información, publicada y accesible de manera libre. Con un web scraper podemos acceder a los datos relevantes con los cuales conseguir entrenar nuestro modelo de Inteligencia Artificial.
Auditoría de marca, reputación online y análisis de sentimiento
Las marcas también utilizan sistemas de raspado para hacer seguimiento de la información compartida por usuarios, o por otras organizaciones relacionadas con sus actividades. De esta manera pueden permanecer alerta sobre eventos que afecten a su reputación online o analizar mejor cómo sus clientes perciben la marca.
Herramientas sin código y extensiones de navegador para usar un web scraper gratis
Realizar un sistema de web scraping mediante programación es una alternativa muy versátil y poderosa, sin embargo, requiere conocimientos y esfuerzo que no siempre están al alcance de todos. Otra posibilidad más sencilla es utilizar herramientas gratuitas que nos permiten realizar la obtención de los datos prácticamente a golpe de clic y sin requerir la realización de aplicaciones desde cero.
Extracción rápida y visual directamente desde la pantalla con Chrome Web Scraper
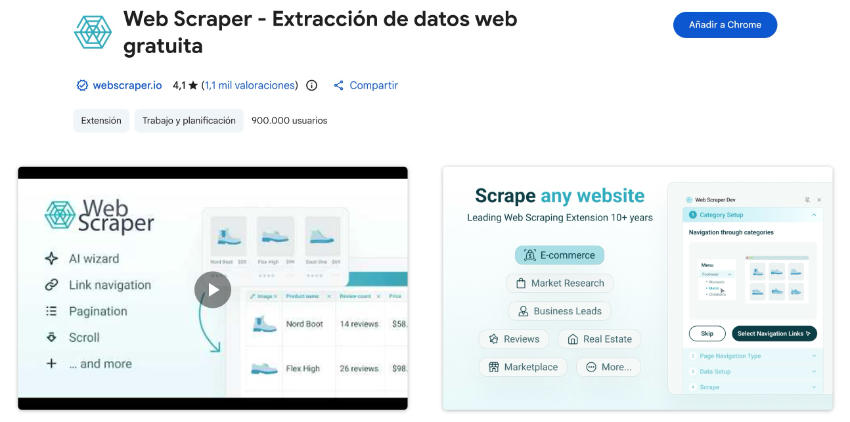
Una utilidad muy popular para el navegador de Google es Chrome Web Scraper. Se trata de una extensión para el navegador que podemos obtener de manera gratuita y que nos permite diversas herramientas para el raspado de datos de las páginas web.
Captura de datos por selección gráfica con herramientas gratuitas como Octoparse
Octoparse es una popular herramienta para hacer web scraping que permite la creación de sistemas de raspado sin necesidad de programar.
Su uso es muy sencillo e intuitivo y te permite obtener datos estructurados a partir de páginas web en pocos minutos. Puedes empezar a utilizarla de manera gratuita, aunque si tienes un uso intensivo necesitas suscribir un plan de pago.
No es la única herramienta web por ejemplo también tienes Browse AI que permite extraer y monitorizar datos de sitios web.
Automatización de flujos de extracción e integración directa mediante n8n
Si quieres ir unos pasos más adelante en lo que respecta a la automatización, puedes utilizar herramientas como n8n que permite crear flujos en los cuales incorporar sistemas de raspado y la comunicación de los datos hacia otros servicios. De esta manera con muy poca o ninguna programación puedes automatizar procesos complejos que incluyan varios pasos, incluso la incorporación de Inteligencia Artificial para extraer y procesar información de diversas fuentes.
Plugins de navegador para la conversión instantánea de tablas web a hojas de cálculo
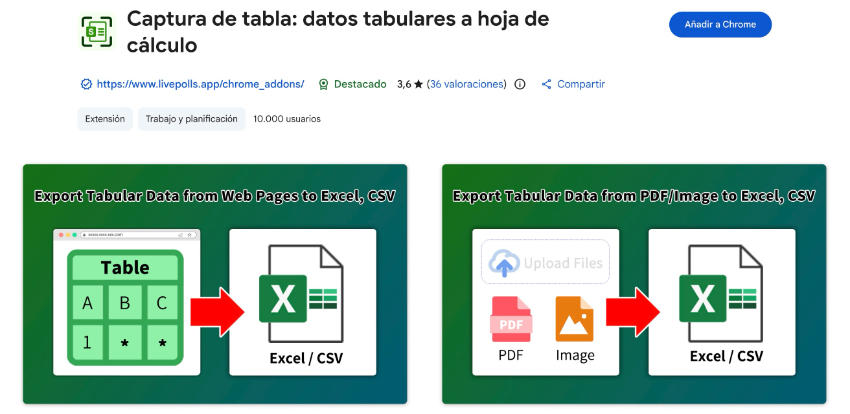
A veces, lo único que necesitamos es extraer datos de páginas web que estamos visualizando en el navegador, y convertirlos en hojas de cálculo. Para ello podemos encontrar extensiones sencillas especializadas como Captura de tabla: datos tabulares a hoja de cálculo.
Exportación automatizada de información hacia Google Sheets y bases de datos
A través de herramientas de automatización como la que hemos mencionado, n8n, o incluso otras como Make o Zapier, podemos realizar flujos complejos que consigan exportar los datos de manera automatizada hacia hojas de cálculo de Google, pero también hacia bases de datos que tengamos alojadas en otros servidores. Esto nos puede quitar una enorme cantidad de trabajo que probablemente tengas que hacer día a día, de modo que tengas todo ese tiempo para dedicarlo a otras tareas más creativas.
Web scraper Python vs. Web scraper JS
Cuando queremos hacer un sistema de raspado realmente versátil y barato, al que además podemos incluir cualquier funcionalidad avanzada, la mejor herramienta es la programación. Podemos usar prácticamente cualquier lenguaje para realizar web scraping, ya que no hace falta más que tener la capacidad de hacer consultas HTTP. Sin embargo, dos lenguajes altamente recomendables para conseguir realizar esta labor son Python y JavaScript.
Estos lenguajes son idóneos porque contienen multitud de librerías que nos pueden facilitar la labor de manera destacable y que vamos a resumir en los próximos puntos.
Ecosistema de bibliotecas en Python con BeautifulSoup, Scrapy y Selenium
Python incluye un nutrido ecosistema de herramientas para realizar web scraping. Las más conocidos son:
- BeautifulSoup: una biblioteca para analizar documentos HTML y XML. Es ideal para analizar páginas estáticas, donde todo el contenido se encuentra directamente en el HTML.
- Scrapy: aquí ya nos encontramos ante un framework completo diseñado específicamente para el rastreo web (crawling) y extracción a gran escala. Es de código abierto, por lo que puedes integrarlo en cualquier aplicación.
- Selenium: Esto ya no es un proyecto de web scraping pero sí una herramienta complementaria muy útil. Básicamente permite acceder a las páginas con un navegador, por lo que podemos procesar Javascript e interaccionar con ella como si fuéramos un usuario real, hasta que llegamos a los datos que se necesitan.
Manejo de sitios web dinámicos con Node.js, Puppeteer y Playwright en JavaScript
JavaScript también ofrece un ecosistema numeroso de herramientas, desde las más básicas que permiten analizar el DOM, hasta otras más avanzadas que nos permiten levantar navegadores y realizar navegación programática, como si un usuario estuviese operando en el propio cliente web.
En este último punto más avanzado, alternativas destacables para levantar navegadores de manera programática son:
- Puppeteer: Una biblioteca de Node.js impulsada por Google que proporciona una API de alto nivel para controlar un navegador Chrome a través del protocolo DevTools.
- Playwright: la alternativa de Microsoft, un poco más moderna e ideal para proyectos de scraping donde necesitas saltar bloqueos un poco más complejos y lidiar con diversos motores de navegación.
Rendimiento y concurrencia: Procesamiento asíncrono frente a ejecución síncrona
Uno de los factores que tenemos que llevar a consideración cuando elegimos un lenguaje de programación para poder hacer técnicas de web scraping es la naturaleza de los lenguajes. Mientras que Python ofrece un procesamiento síncrono JavaScript es asíncrono. Esto tiene connotaciones importantes a la hora de escalar los proyectos, ya que implica distinto grado de recursos y también posibilidad mayor de concurrencia.
Ambos lenguajes permiten alto volumen de procesamiento, aunque la concurrencia está más limitada en Python, ya que depende del procesamiento multi hilo del CPU. En JavaScript, a pesar de manejar un solo hilo puedes trabajar con miles de conexiones simultáneas.
Curva de aprendizaje y facilidad de mantenimiento según el perfil de desarrollo
Cualquiera de las herramientas y lenguajes que hemos nombrado en los puntos anteriores son perfectamente viables para conseguir realizar sistemas de web scraper. Sin embargo, no todas tienen la misma complejidad y a veces la curva de aprendizaje puede ser un poco más compleja con herramientas avanzadas tales como Scrapy o Playwright.
Sin embargo, a decir verdad hoy en día la dificultad de hacer sistemas de web scraper ha descendido notablemente gracias a las herramientas de Inteligencia Artificial (los LLM) que nos permiten crear programas a través de simples mensajes en lenguaje humano. De este modo, la curva de aprendizaje para construir aplicaciones sencillas, y a veces no tan sencillas, ha descendido notablemente.
Criterios de selección del lenguaje en función del volumen de datos y la complejidad web
En scraping, otro de los criterios para seleccionar la herramienta más adecuada es el volumen de datos que queramos obtener o la complejidad de las páginas con las que vamos a trabajar.
Por ejemplo, a veces acceder a los datos es tan sencillo como entrar en una página web a través de su dirección. Sin embargo, en otras ocasiones esos datos están en páginas protegidas para usuarios registrados, con lo cual el proceso requiere varios pasos, como por ejemplo, rellenar un formulario de autenticación y realizar una navegación determinada hasta que obtenemos el dato que buscamos.
También cambia mucho si tenemos que realizar un raspado ocasional sobre una página web o el raspado en un volumen enorme de páginas, incluso si tenemos que realizar esta operación en decenas de sitios o varias veces al día. En esos casos es posible que necesitemos lenguajes capaces de ofrecer un mayor volumen de trabajo con un conjunto de recursos más limitados, de modo que estás operaciones sean menos costosas económicamente para nosotros.
La evolución del web scraper AI y los agentes autónomos
Cómo habíamos adelantado antes, las herramientas de IA han cambiado bastante la manera en la que podemos hacer el raspado de datos en sitios web.
Antes había que hacer operaciones complejas para filtrar el contenido de los sitios. Incluso así estábamos expuestos a la necesidad de mantener estas herramientas cuando el diseño de los sitios web cambiaba y, por lo tanto, cambiaba el lugar donde estaban los contenidos objetivo de nuestras consultas. Hoy en día todo este trabajo se puede resumir de una manera asombrosa utilizando herramientas de Inteligencia Artificial.
Extracción semántica adaptativa ante cambios de diseño e interfaz en sitios web
Los modelos de Inteligencia Artificial son capaces de reconocer el contenido de las páginas web, pero no solo son capaces de extraer texto o números de manera suelta, sino que además son capaces de entenderlo. Gracias a esto , podemos hacer sistemas de scraping con un procedimiento extremadamente sencillo, ya que simplemente tenemos que darle el contenido sin procesar al modelo. Con el HTML en crudo el modelo será capaz de extraer la información que necesitamos, entenderla, y a partir de ella darnos la respuesta con datos estructurados tal como sea necesario para alimentar el sistema objetivo.
Esta posibilidad, aparte de la facilidad de puesta en marcha del proyecto, nos ofrece otra ventaja fundamental y es que es inmune a los cambios de diseño o de la estructura del contenido en los sitios web que estamos utilizando como origen de datos. Al modelo le da igual cómo esté compuesta la página. Es capaz de entenderla y extraer la información, incluso si la página cambia.
Navegación autónoma y toma de decisiones mediante un AI web scraper agent
Pero ya no solo se trata de acceder al contenido, entenderlo y obtener la información estructurada. Hoy podemos ir unos pasos más allá en los sistemas de raspado, para que utilicen la Inteligencia Artificial en la toma de decisiones.
Una vez que obtienen y procesan el contenido son capaces de actuar de una forma totalmente personalizable. Si a esto le unimos sistemas de MCP podríamos luego enviar esos datos fácilmente para cualquier otro servicio, pudiendo darle herramientas al modelo para que, cuando encuentra un contenido en particular, tome decisiones y en función de ellas interactúe con otros servidores. Aquí la imaginación nos puede llevar por caminos extremadamente creativos en los que aprovechar sistemas de web scraping de innumerables formas.
Automatización de la resolución de CAPTCHA y evasión de sistemas anti-bot
Uno de los problemas más importantes para la realización de un sistema de raspado web son los captchas y otros sistemas anti bot. Estos sistemas están hechos justamente para evitar que las máquinas sean capaces de acceder al contenido y utilizarlo para cualquier fin. Hoy los sistemas que impiden el raspado pueden burlarse gracias a la IA, que es capaz de interpretar, incluso de manera masiva, las protecciones anti-bot.
Esto es un problema serio y está provocando una carrera para ver quién es más listo, si los sistemas de IA o los sistemas de protección anti-bot. Esta batalla está aún en un momento incipiente y todavía requiere tiempo para resolverse. Es un tema muy interesante sobre el que puedes investigar por tu cuenta si te interesa.
Limpieza, estructuración y validación de datos en tiempo real mediante LLM
Como hemos dicho antes, con las herramientas de Inteligencia Artificial podemos procesar el contenido de una manera bastante sencilla. Para ello, los LLM están preparados para entender el lenguaje discursivo y a partir de este texto obtener los datos estructurados que requiera nuestro sistema, pero no solo eso, también es capaz de realizar funciones de filtrado y validación de los datos de manera autónoma.
Preguntas frecuentes sobre el web scraping
Antes de terminar queremos repasar algunas dudas. Frecuentes que pueden estar rondando tu cabeza, si es que estás pensando en realizar web scraping.
¿Es legal realizar extracción de datos web en sitios públicos?
Bien, esta es una muy buena pregunta y la verdad es que la respuesta puede ser diferente sobre a quién le preguntes. En principio, si la información que estás obteniendo está publicada de manera libre para los usuarios, es legal acceder a ella y utilizarla para cualquier fin. Sin embargo, esto tiene sus matices porque hay veces que está información puede tener ciertos derechos, como por ejemplo la propiedad intelectual.
En principio, sí obtienes únicamente datos en crudo, no debería ser un problema porque no estás haciendo ningún uso de textos discursivos creados por alguna persona, que no se deban reproducir. Pero, por ejemplo, si estás utilizando titulares de noticias y descripciones de noticias copiadas literalmente de medios informativos, sería importante verificar que esta actividad es consentida.
¿Cómo evitar que un servidor bloquee la dirección IP de tu web scraper?
Hay veces que los sitios web se protegen para que no sé obtengan los datos de manera automatizada de los sitios web. Una es el uso de captchas que ya hemos mencionado en este post, pero otra consiste en el bloqueo de direcciones IP cuando el sitio web detecta que el uso que se está haciendo de sus contenidos está por encima de los límites racionales.
Para evitar que bloqueen tu IP puedes rotarla, aunque te obligue a realizar pasos extra, como por ejemplo la utilización de redes diferentes para realizar saltos desde tu servidor hacia otras redes que permitan ir cambiando la IP de manera periódica. Por ejemplo, puedes utilizar otros servidores servidores cloud creados en el instante para realizar las tareas de raspado del día, usar redes VPN, etc.
¿Cuáles son las mejores alternativas si busco una herramienta de web scraper gratis sin programar?
Las herramientas gratis más potentes son las que se integran con el navegador, como las extensiones que hemos comentado. Si quieres otra alternativa prueba también Instant Data Scraper, pero las más potentes ya las hemos mencionado.

<a href="https://www.linkedin.com/in/nypher">Desarrollador web</a>, crea y mantiene los sitios web de Arsys. También idea herramientas internas que facilitan y mejoran los procesos. Es <strong>experto en desarrollo FrontEnd y en la optimización del rendimiento web</strong>, áreas en las que constantemente busca innovar para ofrecer la mejor experiencia online.